- Tìm hiểu công nghệ và lợi ích của phần mềm chuyển đổi văn bản thành giọng nói text to speech
- Nguyên lý hoạt động của công nghệ TTS dựa trên trí tuệ nhân tạo
- Tại sao nên sử dụng công cụ TTS cho giáo dục và sản xuất video?
- Hướng dẫn chi tiết cách thực hiện chuyển đổi văn bản thành giọng nói
- Các bước chuyển đổi văn bản cơ bản và tinh chỉnh tốc độ, khoảng dừng
- Cách tạo giọng đọc tự động chuyên nghiệp trong phần mềm chỉnh sửa CapCut
Tìm hiểu công nghệ và lợi ích của phần mềm chuyển đổi văn bản thành giọng nói text to speech
Trong kỷ nguyên số hóa, phần mềm chuyển đổi văn bản thành giọng nói text to speech đang trở thành một trong những công nghệ trí tuệ nhân tạo mang tính cách mạng, thay đổi hoàn toàn cách chúng ta tương tác với thông tin. Bản chất của công nghệ TTS là ứng dụng AI để biến các văn bản viết thành lời nói nhân tạo có ngữ điệu tự nhiên, gần giống với giọng đọc của con người nhờ quy trình xử lý văn bản tinh vi và các mô hình học sâu tiên tiến như WaveNet hay Tacotron 2.
Không chỉ dừng lại ở một tiện ích công nghệ đơn thuần, việc ứng dụng các giải pháp text to speech mang lại nhiều lợi ích vượt trội cho cả cá nhân lẫn doanh nghiệp:
- Tăng khả năng tiếp cận: Hỗ trợ đắc lực cho người khiếm thị, người mắc chứng khó đọc dễ dàng tiếp thu tài liệu số, sách báo và trang web.
- Tối ưu hóa giáo dục: Giúp học sinh, sinh viên tiếp thu kiến thức theo hình thức đa kênh (thính giác kết hợp thị giác), hỗ trợ học ngoại ngữ và luyện phát âm hiệu quả.
- Tiết kiệm chi phí sản xuất: Tự động hóa khâu lồng tiếng, thuyết minh cho video, podcast và sách nói mà không cần đầu tư phòng thu chuyên nghiệp hay thuê nhân sự.
- Nâng cấp trải nghiệm người dùng: Được tích hợp sâu vào hệ thống định vị GPS, trợ lý ảo thông minh, tổng đài chăm sóc khách hàng tự động và các thiết bị IoT trong nhà.
Sự phát triển mạnh mẽ của công nghệ này đang từng bước xóa nhòa khoảng cách giữa văn bản tĩnh và âm thanh sống động, mở ra không gian trải nghiệm nội dung số toàn diện hơn bao giờ hết.
Nguyên lý hoạt động của công nghệ TTS dựa trên trí tuệ nhân tạo
Công nghệ chuyển văn bản thành giọng nói (Text to Speech – TTS) hiện đại đã có những bước tiến vượt bậc nhờ sự can thiệp của trí tuệ nhân tạo (AI) và học sâu (Deep Learning). Thay vì chỉ ghép nối các âm tiết rời rạc như trước đây, quy trình hoạt động của các hệ thống TTS ngày nay được chia thành hai giai đoạn chính vô cùng tinh vi: Xử lý văn bản (Text Processing) và Tổng hợp giọng nói (Speech Synthesis).
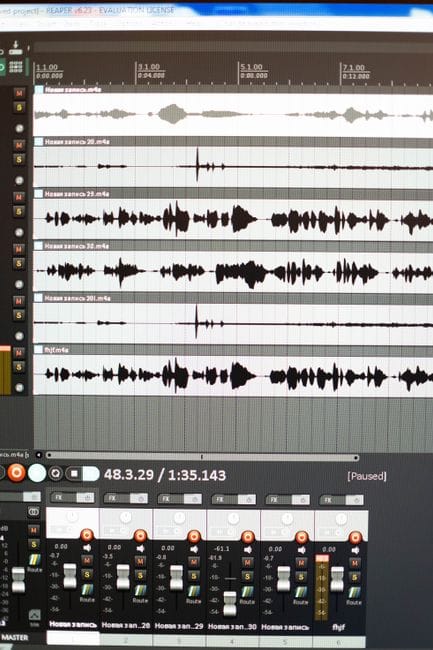
Ở giai đoạn đầu, hệ thống tiến hành phân tích cấu trúc câu, dấu câu để thấu hiểu ngữ cảnh, đồng thời chuyển đổi các ký hiệu đặc biệt, số, ngày tháng hoặc từ viết tắt thành dạng chữ viết đầy đủ có thể phát âm. Sang giai đoạn tổng hợp, văn bản đã chuẩn hóa sẽ được chuyển đổi thành đặc trưng âm thanh mô phỏng sóng âm (Mel Spectrogram) nhờ các mạng nơ-ron tiên tiến. Cuối cùng, bộ giải mã âm thanh Vocoder sẽ biến đổi dữ liệu này thành dạng sóng hoàn chỉnh, tạo ra giọng đọc trôi chảy.
Để đạt được độ chân thực cao, ngắt nghỉ hợp lý và diễn đạt mượt mà gần giống giọng người thật, các mô hình học sâu cốt lõi đóng vai trò quyết định. Những cái tên tiêu biểu như WaveNet, Tacotron 2 hay WaveGlow chính là chìa khóa giúp phần mềm chuyển đổi văn bản thành giọng nói text to speech ngày càng thông minh, linh hoạt và mang lại trải nghiệm nghe tự nhiên nhất cho người dùng.
Tại sao nên sử dụng công cụ TTS cho giáo dục và sản xuất video?
Sự bùng nổ của công nghệ trí tuệ nhân tạo đã biến phần mềm chuyển đổi văn bản thành giọng nói text to speech trở thành trợ thủ đắc lực không thể thiếu trong hai lĩnh vực trọng điểm là giáo dục và sản xuất nội dung video. Đối với ngành giáo dục, công cụ này giúp chuyển hóa kho tàng tài liệu, sách giáo khoa thành định dạng âm thanh sinh động. Điều này tạo điều kiện cho người học tiếp thu kiến thức theo phương pháp đa kênh (kết hợp thính giác và thị giác), hỗ trợ đắc lực cho người khiếm thị hoặc mắc chứng khó đọc, đồng thời cải thiện đáng kể hiệu quả học ngoại ngữ và ghi nhớ từ vựng.
Trong khi đó, đối với các nhà sáng tạo nội dung và nhà làm phim, việc tích hợp phần mềm chuyển đổi văn bản thành giọng nói text to speech giúp giải quyết bài toán tối ưu hóa chi phí và thời gian sản xuất. Thay vì phải tốn kém ngân sách thuê phòng thu chuyên nghiệp, diễn viên lồng tiếng hay mất hàng giờ thu âm lại, các công cụ TTS hiện đại cho phép tạo ra hàng loạt giọng đọc thuyết minh, lồng tiếng podcast hoặc video ngắn (TikTok, YouTube Shorts) chỉ trong tích tắc. Sự đa dạng về phong cách giọng đọc, khả năng điều chỉnh tốc độ linh hoạt cùng độ chân thực cao giúp các video trở nên thu hút, giữ chân người xem tốt hơn mà vẫn đảm bảo tính chuyên nghiệp.
Hướng dẫn chi tiết cách thực hiện chuyển đổi văn bản thành giọng nói
Để tận dụng tối đa sức mạnh của phần mềm chuyển đổi văn bản thành giọng nói text to speech, việc nắm vững quy trình thực hiện chuẩn xác là yếu tố then chốt giúp bạn sở hữu các tệp âm thanh chất lượng cao. Quá trình này bắt đầu từ việc chuẩn bị kỹ lưỡng nội dung văn bản, đòi hỏi văn bản phải rõ ràng, đúng chính tả và ngữ pháp để hạn chế tối đa lỗi phát âm của AI. Tiếp theo, bạn cần lựa chọn công cụ phù hợp với nhu cầu, tiến hành dán văn bản và lựa chọn cấu hình giọng đọc nam hoặc nữ với độ tuổi, phong cách tương ứng.
Điểm mấu chốt để tạo ra một bản thu âm tự nhiên nằm ở khâu tinh chỉnh các thông số kỹ thuật. Bạn có thể chủ động điều chỉnh tốc độ đọc linh hoạt (như 0.7x – 0.8x cho nội dung học tập, hoặc 1.2x – 1.5x cho video ngắn), chèn các khoảng dừng hợp lý tại vị trí cần ngắt nghỉ, cũng như cấu hình lại các từ viết tắt, từ ngoại lai vào bảng phát âm chuyên dụng. Cuối cùng, hãy luôn nghe thử để tối ưu hóa ngữ điệu trước khi nhấn chuyển đổi và tải tệp âm thanh hoàn chỉnh về máy dưới định dạng MP3 hoặc WAV.
Các bước chuyển đổi văn bản cơ bản và tinh chỉnh tốc độ, khoảng dừng
Để tận dụng tối đa hiệu quả của phần mềm chuyển đổi văn bản thành giọng nói text to speech, việc nắm vững quy trình thao tác cơ bản cùng các kỹ thuật tinh chỉnh thông số là vô cùng quan trọng. Quá trình này giúp bạn chủ động kiểm soát chất lượng âm thanh đầu ra sao cho mượt mà, tự nhiên và phù hợp nhất với mục đích sử dụng.
Quy trình thực hiện chuẩn xác bao gồm các bước cốt lõi sau:
- Bước 1 – Chuẩn bị văn bản: Soạn thảo nội dung rõ ràng, kiểm tra kỹ chính tả và ngữ pháp để hạn chế tối đa tình trạng AI đọc sai.
- Bước 2 & 3 – Chọn công cụ và nhập liệu: Truy cập phần mềm, dán văn bản vào khung nhập liệu, sau đó lựa chọn ngôn ngữ cùng giới tính, độ tuổi của giọng đọc (nam/nữ) phù hợp.
- Bước 4 – Tùy chỉnh thông số chuyên sâu: Thiết lập tốc độ đọc linh hoạt (từ 0.7x – 0.8x cho nội dung học tập, 1.0x cho video thông thường và 1.2x – 1.5x cho video ngắn năng động). Đồng thời, chèn các khoảng dừng (từ 0.5s đến 2s) tại các dấu câu để tạo nhịp điệu tự nhiên, kết hợp cấu hình phát âm riêng cho từ viết tắt hoặc từ ngoại lai.
- Bước 5 – Hoàn thiện: Nhấn nút chuyển đổi, lắng nghe bản phát thử để tinh chỉnh lại những điểm chưa ưng ý và tiến hành tải tệp âm thanh định dạng MP3 hoặc WAV về máy.
Việc kết hợp linh hoạt giữa các bước chuẩn bị kỹ lưỡng và thao tác tinh chỉnh thông minh sẽ giúp bạn tạo ra những đoạn audio chất lượng cao, chuyên nghiệp mà không mất nhiều thời gian xử lý hậu kỳ.
Cách tạo giọng đọc tự động chuyên nghiệp trong phần mềm chỉnh sửa CapCut
CapCut là một trong những ứng dụng chỉnh sửa video phổ biến hiện nay nhờ tích hợp sẵn tính năng phần mềm chuyển đổi văn bản thành giọng nói text to speech vô cùng tiện lợi. Để tạo ra những thước phim có giọng đọc tự động chuyên nghiệp, bạn chỉ cần thực hiện theo các bước thao tác trực quan ngay trên giao diện ứng dụng.
Đầu tiên, hãy mở ứng dụng, tạo dự án mới và tải video hoặc hình ảnh cần xử lý lên dòng thời gian. Tiếp theo, bạn chọn tính năng ‘Text’ (Văn bản), nhấn ‘Add Text’ (Thêm chữ) và nhập đoạn nội dung cần chuyển đổi. Căn chỉnh vị trí và kéo dài hoặc thu ngắn thời lượng hiển thị của đoạn chữ sao cho thật ăn khớp với phân cảnh video thực tế.
Sau đó, bạn chọn đoạn chữ vừa nhập và kích hoạt tính năng Text-to-Speech. Tại đây, hãy lựa chọn ngôn ngữ cùng kiểu giọng đọc phù hợp với chủ đề tổng thể của video, chẳng hạn như chọn giọng đọc nhẹ nhàng, truyền cảm cho các video review sản phẩm hoặc giọng vui tươi, năng động cho các nội dung giải trí ngắn. Cuối cùng, bạn chỉ cần chọn phân đoạn âm thanh vừa được AI tạo tự động nằm ở dòng thời gian bên dưới, điều chỉnh lại tốc độ hoặc thêm hiệu ứng nếu muốn, kiểm tra độ khớp giữa hình ảnh và âm thanh rồi tiến hành xuất video hoàn chỉnh.



Để lại bình luận